IA en Marketing: medir calidad antes de calcular tiempo ahorrado


Un flujo de IA puede producir un borrador en segundos y aumentar el tiempo necesario para entregar un trabajo correcto. La revisión, las fuentes, las correcciones y las excepciones forman parte del proceso, aunque no aparezcan en la demostración.
Para decidir si merece escalarse, primero hay que definir qué significa una entrega válida. Después podemos medir tiempo y coste sobre resultados comparables. La velocidad solo tiene valor dentro de una condición de calidad suficiente.
Elegir una tarea y una unidad verificable
Preparar un brief, resumir entrevistas y redactar una propuesta son tareas distintas. Cada una necesita entradas, límites y criterios propios. Evaluarlas como productividad general oculta dónde ayuda la IA y dónde desplaza trabajo.
Una unidad puede ser un brief que el equipo puede utilizar sin reconstruirlo, una clasificación correcta o una respuesta apoyada en fuentes válidas. El archivo generado es un resultado intermedio; la unidad útil llega cuando alguien puede usarlo para su propósito.
Antes del piloto escribiría qué campos son obligatorios, qué fuentes se admiten y qué errores obligan a rechazar la salida. Ese acuerdo debe existir también para el proceso manual.
Crear casos que representen el trabajo real
La evaluación necesita tareas habituales, ambiguas y difíciles. Un conjunto compuesto solo por ejemplos fáciles mostrará una calidad que no representa la operación.
En un brief de Marketing incluiría información incompleta, fuentes contradictorias, fechas antiguas, restricciones de marca y preguntas que no pueden responderse con los datos disponibles. Reconocer que falta evidencia puede ser la salida correcta.
Separaría los casos utilizados para ajustar las instrucciones de otros que sirvan para comprobar el resultado. Si corregimos el sistema mirando siempre las mismas preguntas, podemos aprender a resolver ese examen sin mejorar la tarea.
El marco de medición de NIST propone documentar pruebas, métricas y límites de funcionamiento. La rúbrica que sigue es una adaptación práctica para este tipo de trabajo, no una certificación del sistema.
Puntuar dimensiones sin esconder los errores graves
Para un borrador comprobaría exactitud, trazabilidad, utilidad, completitud y adecuación al contexto. Cada dimensión necesita ejemplos de aceptable e inaceptable para que dos revisores no puntúen cosas diferentes.
También establecería errores críticos: inventar una fuente, divulgar un dato no autorizado o formular una promesa comercial incompatible con la información disponible. Un promedio alto no debe compensarlos.
Una salida puede recibir buena puntuación de estilo y seguir siendo inutilizable por un dato central falso. Por eso conviene registrar tipo de fallo y severidad, además de una nota global.
Las discrepancias entre revisores son información. Si el criterio es ambiguo, mejorar la rúbrica puede aportar más que cambiar de modelo.
Un caso con ahorro aparente y trabajo pendiente
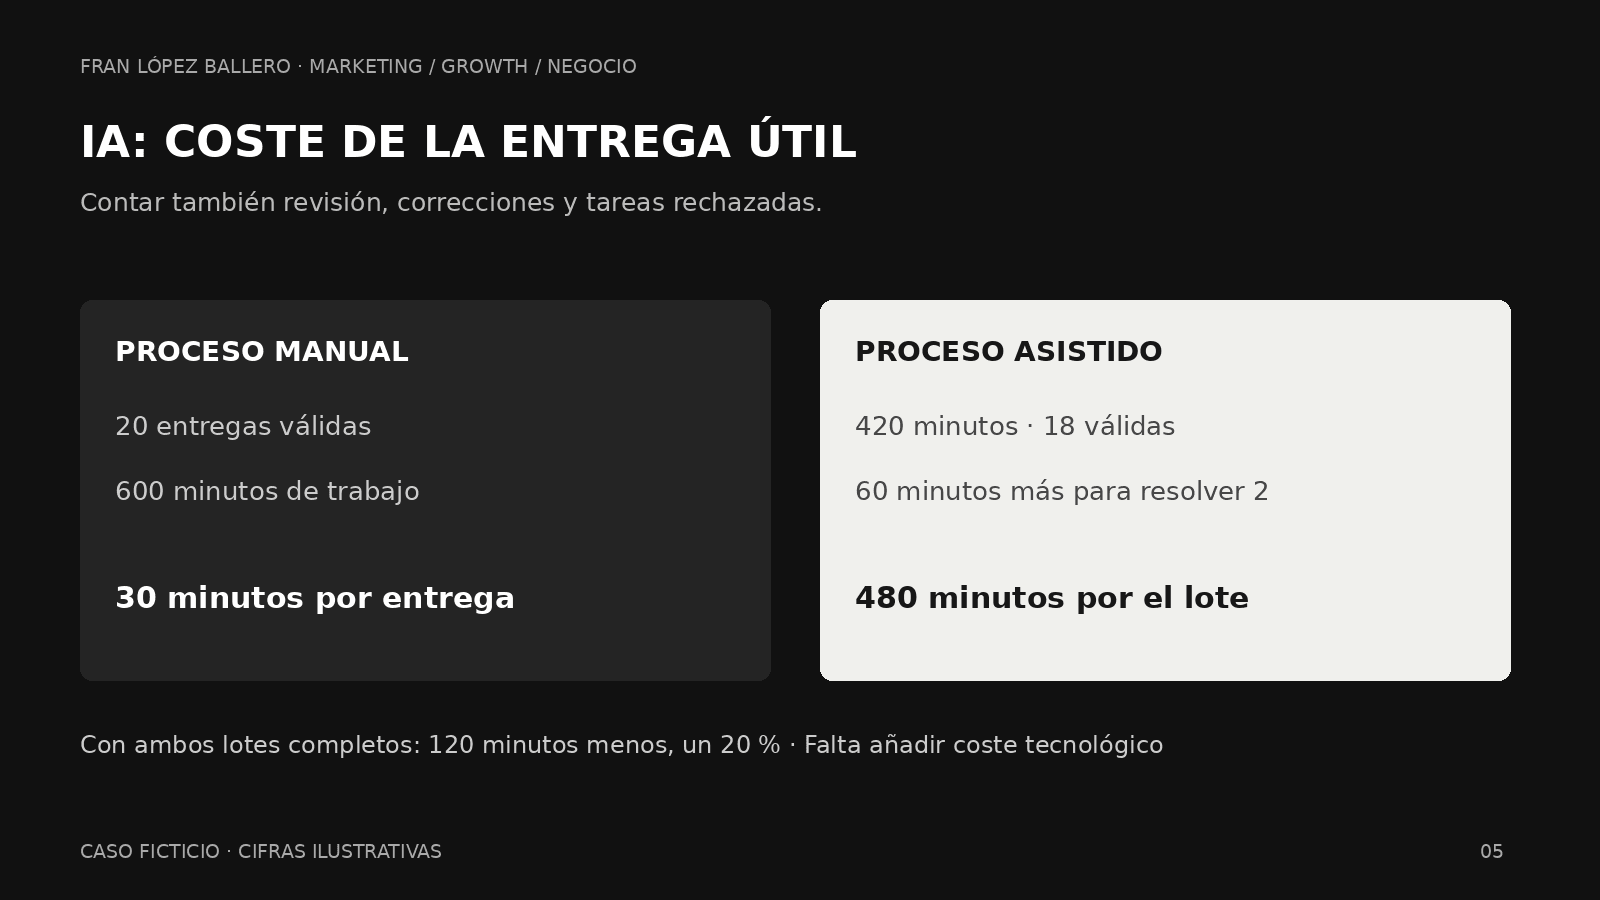
Este caso es ficticio. El proceso manual resuelve veinte entregas válidas en 600 minutos: treinta por entrega.
Con asistencia de IA, la preparación y generación ocupa ochenta minutos; revisar las veinte salidas, 220; corregir, noventa; y gestionar excepciones, treinta. El total es de 420 minutos. Dieciocho entregas cumplen el criterio y dos siguen rechazadas.
Dividir 420 entre dieciocho da unos 23,3 minutos por entrega útil. La productividad aparente mejora, pero el trabajo no está completo: quedan dos tareas y es necesario saber por qué fallaron.
Si resolver cada una manualmente requiere treinta minutos adicionales, el total del lote asciende a 480. Frente a los 600 iniciales, el ahorro observado es de 120 minutos, un 20 %. No el porcentaje espectacular que sugeriría comparar solo el tiempo de generación.
La comparación también necesita igualdad de dificultad y estándar. Si los dos lotes contienen tareas distintas, la diferencia puede proceder de la selección de casos.
Pasar del tiempo al coste completo
Además de minutos, incorporaría uso tecnológico, integración, evaluación, mantenimiento y revisión. El coste por entrega válida resulta más útil que el coste por llamada al modelo.
En el ejemplo, con un coste de trabajo ilustrativo de treinta euros por hora, el proceso manual representa 300 euros. Las ocho horas finales del flujo asistido representan 240. Si el coste tecnológico y operativo asignado al lote es de veinte euros, el total sería de 260 y el ahorro, cuarenta.
Este cálculo no añade valor económico a las horas liberadas por defecto. Para capturarlo hace falta utilizarlas en otra actividad útil, reducir una restricción o evitar trabajo adicional. Capacidad liberada y ahorro de caja no son equivalentes.
Si aparece un error crítico, la decisión puede ser detener el despliegue aunque el cálculo de coste resulte favorable. El límite de calidad debe seguir visible.
Comparar el proceso completo
Cuando sea posible, asignaría tareas comparables a ambos procesos y registraría el tiempo de principio a fin. En una evaluación de textos, la revisión puede hacerse sin indicar cómo se generó cada versión para reducir expectativas del evaluador.
El registro debe incluir correcciones silenciosas. Si una persona reescribe un párrafo fuera del sistema y ese tiempo desaparece, la evaluación presenta una mejora artificial.
También observaría cuánto trabajo llega al siguiente equipo. Un brief aceptado rápido que obliga a Diseño o Ventas a pedir aclaraciones no ha eliminado ese coste: lo ha desplazado.
La arquitectura de agentes de IA necesita estos límites antes de ampliar autonomía. Recuperar documentación mediante RAG tampoco sustituye la comprobación de la salida.
Cuándo ampliar y cuándo volver a revisar
Escalaría una tarea cuando supere el criterio acordado, sus fallos sean comprensibles y exista un responsable de operación. El nivel de revisión humana depende del impacto, no de lo convincente que suene el texto.
Cambiar de modelo, instrucciones, corpus o población puede alterar el resultado. Conservaría versión y casos de evaluación para repetir la comprobación ante cambios relevantes.
El piloto puede empezar con una tarea pequeña y una ficha por entrega: correcta o rechazada, motivo, gravedad, minutos de preparación, revisión y corrección, y resultado final. Ese registro permite decidir qué automatizar y qué rediseñar.
Una buena evaluación termina con una decisión concreta: ampliar, mantener supervisión, corregir un componente o abandonar el flujo. La IA aporta valor cuando mejora una entrega que merece hacerse, con calidad suficiente y un coste completo que compensa.