Cómo construir un sistema RAG para Marketing con IA


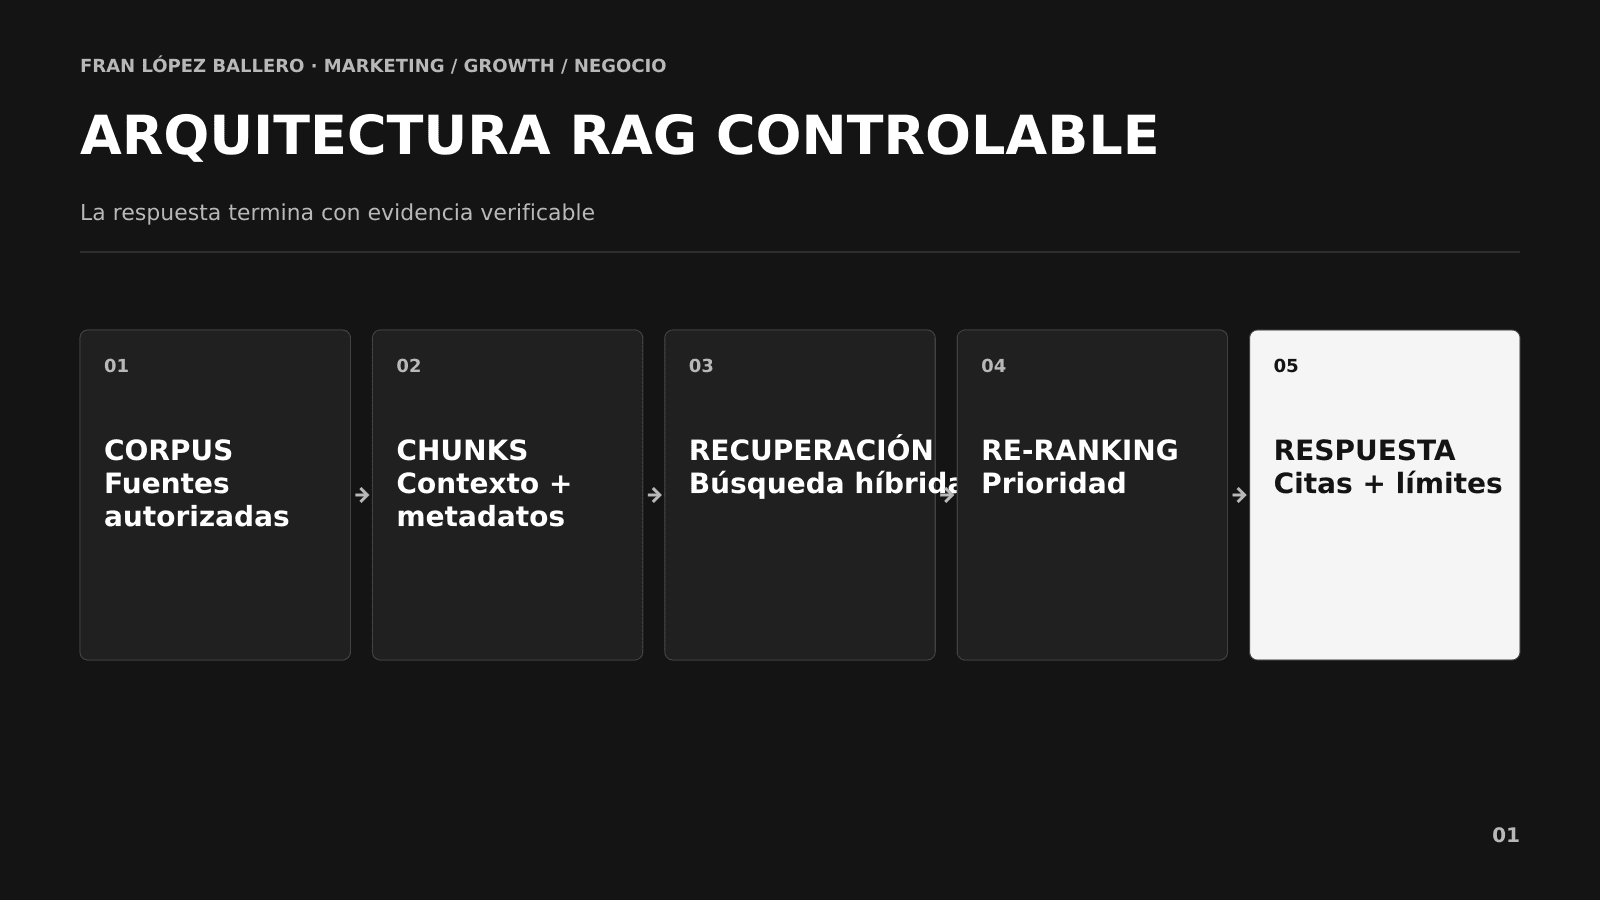
Un sistema RAG para Marketing combina un modelo generativo con una capa de recuperación que busca información en fuentes controladas antes de responder. Su objetivo no es que la IA «sepa más», sino que utilice el conocimiento correcto, vigente y permitido, y que pueda mostrar de dónde procede cada afirmación.
RAG son las iniciales de Retrieval-Augmented Generation. En lugar de confiar únicamente en lo aprendido por el modelo, el sistema recupera fragmentos relevantes de briefs, research, campañas, guías de marca, documentación de producto o decisiones anteriores. Después construye una respuesta apoyada en ese contexto.
La arquitectura es importante, pero el activo estratégico no es el chatbot. Es el corpus gobernado, el sistema de permisos, la evaluación y el aprendizaje acumulado alrededor de preguntas reales.
Cuándo tiene sentido utilizar RAG en Marketing
RAG aporta valor cuando el conocimiento cambia, está disperso, debe citarse o necesita respetar permisos. Algunos casos razonables:
• Responder preguntas sobre campañas y resultados históricos.
• Preparar briefs utilizando research y aprendizajes previos.
• Consultar guías de marca y mensajes aprobados.
• Ayudar a Ventas con información de producto, casos y objeciones.
• Recuperar decisiones, responsables y contexto de proyectos.
• Comparar mercados sin mezclar versiones ni periodos.
No lo utilizaría para todo. Si la respuesta cabe en una regla estable, una base de datos o un formulario, añadir un modelo generativo introduce coste y variabilidad. Tampoco debería ejecutar acciones externas sin controles específicos.
La pregunta inicial no es «¿qué base vectorial elegimos?». Es: ¿qué decisión o tarea queremos mejorar, qué evidencia necesita y qué error no podemos permitir?
La arquitectura mínima de un sistema RAG
Un flujo controlable contiene nueve pasos.
1. Ingesta: importar documentos y datos autorizados.
2. Normalización: limpiar formato, duplicados y versiones obsoletas.
3. Fragmentación: dividir el contenido conservando contexto.
4. Representación: generar embeddings u otras señales de búsqueda.
5. Almacenamiento: guardar texto, vectores y metadatos.
6. Recuperación: encontrar candidatos para la pregunta.
7. Reordenación: priorizar los fragmentos más relevantes.
8. Generación: responder utilizando únicamente el contexto válido.
9. Trazabilidad: devolver citas, registrar calidad y recoger feedback.
Cada etapa puede fallar de una forma distinta. Si no aparece una fuente correcta, el problema es de corpus o recuperación. Si aparece y el modelo la interpreta mal, el problema está en el prompt, la síntesis o la evaluación. Llamar «alucinación» a todo impide corregir el componente adecuado.
Diseñar el corpus: menos volumen y más gobernanza
Un Drive lleno de archivos no es todavía una base de conocimiento. Antes de indexar, resolvería propiedad, vigencia, duplicados, confidencialidad y jerarquía de fuentes.
Los metadatos mínimos dependen del caso, pero en Marketing incluiría:
• Propietario y área.
• Fecha y periodo de validez.
• Mercado, producto y audiencia.
• Campaña o proyecto.
• Tipo de documento.
• Nivel de confidencialidad.
• Estado: borrador, aprobado, sustituido o archivado.
• Fuente primaria o derivada.
Sin metadatos, una búsqueda semántica puede recuperar una conclusión muy parecida y completamente incorrecta para el país, la versión o el momento actual.
También definiría precedencia. Una política aprobada debe pesar más que una presentación antigua; un dato de la fuente maestra, más que una captura pegada en un informe. Cuando dos documentos se contradicen, el sistema debería mostrar el conflicto o abstenerse, no elegir el texto más fluido.
Chunking: dividir sin romper el razonamiento
El chunking no consiste en cortar cada 500 tokens. Un brief, una tabla y una recomendación tienen estructuras diferentes.
Mantendría juntas definición, evidencia y conclusión cuando forman una unidad lógica. Repetiría títulos jerárquicos en los fragmentos para conservar contexto. Separaría anexos numéricos si requieren consulta estructurada y evitaría que una tabla quedase sin encabezados.
El tamaño óptimo se evalúa, no se adivina. Fragmentos demasiado pequeños pierden relaciones; demasiado grandes añaden ruido y ocupan contexto. Una buena estrategia puede combinar búsqueda por documento, sección y fragmento.
Recuperación y re-ranking
La recuperación híbrida suele combinar similitud semántica con búsqueda léxica y filtros de metadatos. La semántica encuentra ideas expresadas con palabras distintas; la búsqueda por términos protege nombres, códigos y cifras exactas.
Después, un re-ranker puede ordenar los candidatos según su relación con la pregunta. Recuperar veinte fragmentos y enviarlos todos al modelo no es prudencia: aumenta coste, latencia y probabilidad de contradicción.
También conviene reescribir preguntas conversacionales. «¿Y en Portugal?» necesita incorporar el tema anterior antes de buscar, pero sin inventar intención que el usuario no expresó.
Un ejemplo de evaluación de extremo a extremo
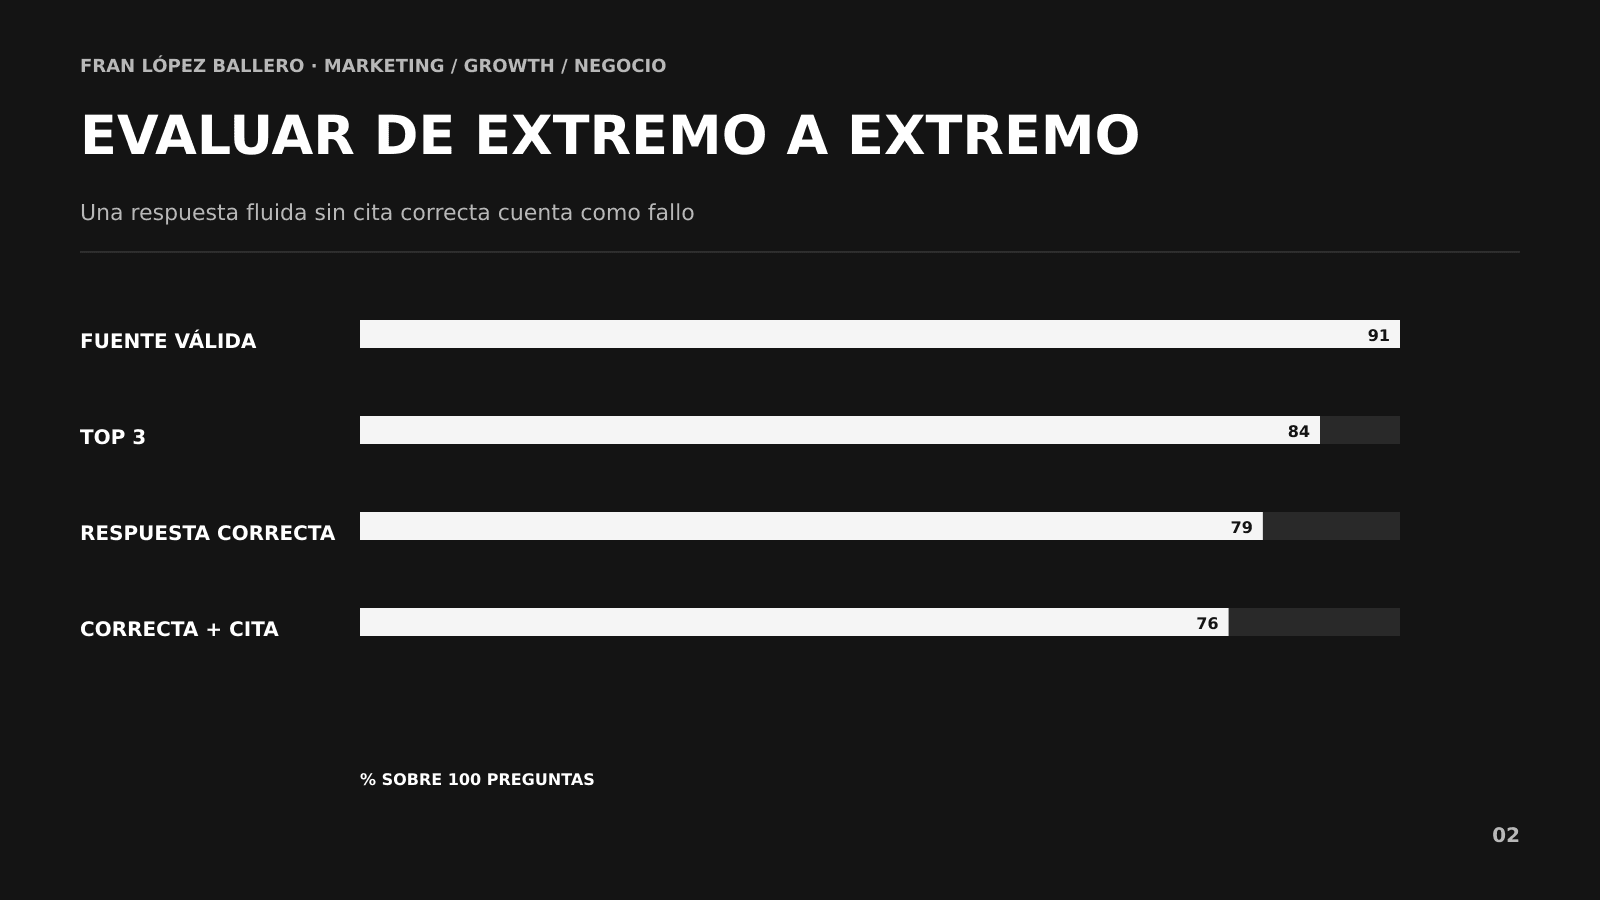
Construiría un conjunto de preguntas reales con respuesta esperada, documentos relevantes y criterios de calidad. Este ejemplo utiliza cifras ilustrativas.
• Etapa · Resultado sobre 100 preguntas
• Recupera al menos una fuente válida · 91
• Coloca una fuente válida entre las tres primeras · 84
• Responde correctamente · 79
• Responde correctamente y cita bien · 76
El 76 %, no el 91 %, representa la calidad útil. El análisis de los 24 fallos indicará si falta documentación, el buscador recupera mal, el re-ranking se equivoca, el modelo contradice la evidencia o la pregunta debería terminar en abstención.
Mediría al menos:
• Recall de recuperación.
• Precisión de citas.
• Corrección y completitud.
• Tasa de contradicción.
• Tasa de abstención correcta.
• Latencia y coste por respuesta.
• Intervención humana necesaria.
• Impacto en la tarea: tiempo, error o adopción.
Una respuesta persuasiva sin evidencia correcta cuenta como fallo.
Seguridad, permisos y prompt injection
Los permisos deben aplicarse antes de recuperar contenido. No basta con pedir al modelo que «no revele información». El sistema no debe introducir en el contexto documentos que el usuario no puede consultar.
Los archivos también son entrada no confiable. Un documento puede contener instrucciones maliciosas o accidentales dirigidas al modelo. El pipeline debe separar contenido de instrucciones, limitar herramientas, registrar acciones y tratar cada fuente según su nivel de confianza.
Para acciones de impacto —publicar, enviar, modificar presupuesto o contactar clientes— exigiría aprobación humana y controles deterministas. RAG puede aportar evidencia; no convierte al modelo en propietario de la decisión.
También protegería datos personales, contratos, información comercial y secretos empresariales con retención, cifrado, aislamiento y auditoría adecuados. «Está dentro de la empresa» no es un modelo de permisos.
Cómo implementar un RAG de Marketing paso a paso
1. Selecciona una tarea concreta. Preguntas de campañas, briefs o enablement, no «todo el conocimiento».
2. Define la respuesta correcta. Qué debe citar, cuándo debe abstenerse y qué error es crítico.
3. Crea un corpus pequeño y limpio. Documentos aprobados, con propietario y vigencia.
4. Diseña metadatos y acceso. Antes de embeddings.
5. Construye una línea base. Búsqueda simple para saber si la complejidad aporta valor.
6. Prepara preguntas de evaluación. Incluye casos fáciles, ambiguos, conflictivos y sin respuesta.
7. Ajusta chunking y recuperación. Sobre fallos reales.
8. Añade generación con citas. Instruye al sistema para reconocer límites.
9. Mide tarea y economía. Calidad, tiempo ahorrado, coste e intervención.
10. Opera el corpus. Versionado, caducidad, feedback y revisión.
Construir o comprar
Construir internamente tiene sentido cuando el conocimiento, los permisos, la evaluación o la integración son diferenciales. Comprar suele ser mejor cuando el caso es estándar y operar infraestructura no crea ventaja.
La decisión también depende de coste total: ingestión, observabilidad, soporte, evaluación, seguridad y mantenimiento del corpus. Una demo puede montarse en días; un sistema confiable necesita ownership permanente.
Errores frecuentes en proyectos RAG
• Indexar todo antes de definir una tarea.
• Confiar en documentos duplicados y sin vigencia.
• Cortar texto por tamaño ignorando estructura.
• Medir solo si la respuesta «suena bien».
• Confundir recuperación con corrección final.
• No incluir preguntas sin respuesta.
• Aplicar permisos después de recuperar.
• Dar herramientas de acción sin aprobación.
• Evaluar una vez y dejar de observar cambios.
Preguntas frecuentes sobre RAG
¿RAG elimina las alucinaciones?
No. Reduce algunos errores al aportar fuentes, pero puede recuperar mal, citar de forma incorrecta o interpretar mal la evidencia. Necesita evaluación y abstención.
¿Hace falta una base vectorial?
No siempre. Para corpus pequeños o preguntas exactas, búsqueda léxica y filtros pueden ser suficientes. La arquitectura debe responder al caso, no a la moda.
¿Qué diferencia un piloto de un sistema de producción?
Permisos, trazabilidad, evaluación repetible, observabilidad, gestión de versiones, respuesta ante incidentes y un propietario del corpus.
Conclusión: la ventaja no es el chatbot
Un RAG valioso no es el que responde más preguntas, sino el que ayuda a una tarea concreta con evidencia verificable y límites claros.
En Marketing, su ventaja aparece cuando convierte documentos dispersos en memoria operativa: recupera lo relevante, explica de dónde sale y permite que el equipo aprenda sin reconstruir el contexto cada vez. La tecnología importa. La calidad del conocimiento y de las decisiones que produce importa bastante más.