Agentes de IA para Marketing: arquitectura, control y evaluación


Un agente de IA es un sistema que utiliza un modelo para interpretar un objetivo, elegir acciones y operar herramientas dentro de unos límites definidos. En Marketing puede investigar, preparar borradores, clasificar información, actualizar sistemas o coordinar flujos. Pero automatizar una tarea no equivale a delegar ownership.
La arquitectura senior empieza por riesgo y evaluación, no por autonomía. Cuanto mayor sea el impacto de una acción —publicar, modificar presupuesto, contactar a un cliente o utilizar datos sensibles— más deterministas deben ser los controles y más clara la intervención humana.
La pregunta adecuada no es «¿podemos crear un agente?». Es: ¿qué decisión puede tomar, qué evidencia necesita, qué herramientas puede usar y cómo sabremos que funciona mejor que el proceso actual?
Qué diferencia a un agente de una automatización tradicional
Una automatización clásica ejecuta reglas predefinidas: si ocurre A, realiza B. Un agente introduce razonamiento probabilístico para interpretar entradas variables, seleccionar pasos o decidir qué herramienta utilizar.
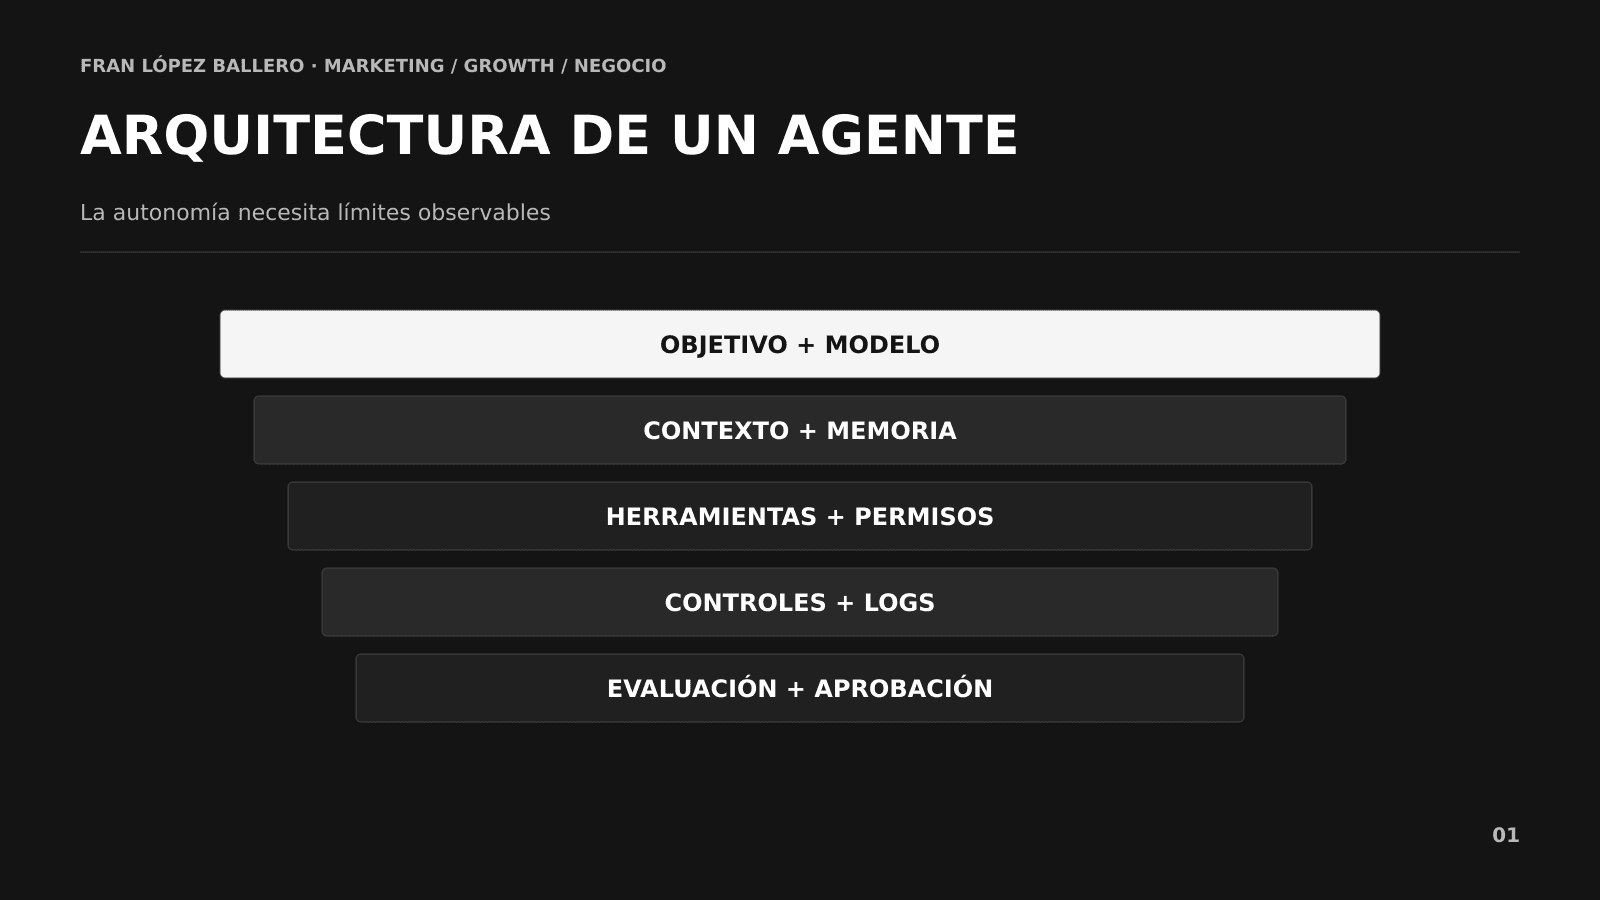
Sus componentes suelen incluir:
• Objetivo e instrucciones.
• Modelo.
• Herramientas y permisos.
• Contexto o recuperación de conocimiento.
• Estado o memoria de trabajo.
• Bucle de planificación y ejecución.
• Controles, logs y evaluación.
• Puntos de aprobación humana.
No toda tarea necesita un agente. Si el flujo es estable y las excepciones conocidas, una automatización determinista suele ser más barata, rápida y verificable.
Casos de uso razonables en Marketing
Research asistido
Recopilar fuentes autorizadas, extraer afirmaciones y preparar una síntesis con citas. El agente reduce trabajo mecánico; una persona valida relevancia y conclusión.
Operaciones de contenido
Convertir un brief aprobado en variantes, comprobar requisitos y preparar una cola editorial. Publicar debe requerir revisión cuando existe riesgo de marca o factual.
QA de campañas
Revisar nomenclatura, URLs, parámetros, formatos y coherencia frente al brief. Las reglas duras deben seguir siendo deterministas; el modelo ayuda con ambigüedad.
Voz de cliente
Clasificar tickets, entrevistas y reseñas, proponer temas y enlazar ejemplos. Necesita protección de datos y muestreo para comprobar sesgo.
Asistencia comercial
Preparar contexto de cuenta y borradores utilizando fuentes permitidas. Nunca debería inventar hechos ni enviar sin el nivel de aprobación acordado.
Arquitectura por niveles de autonomía
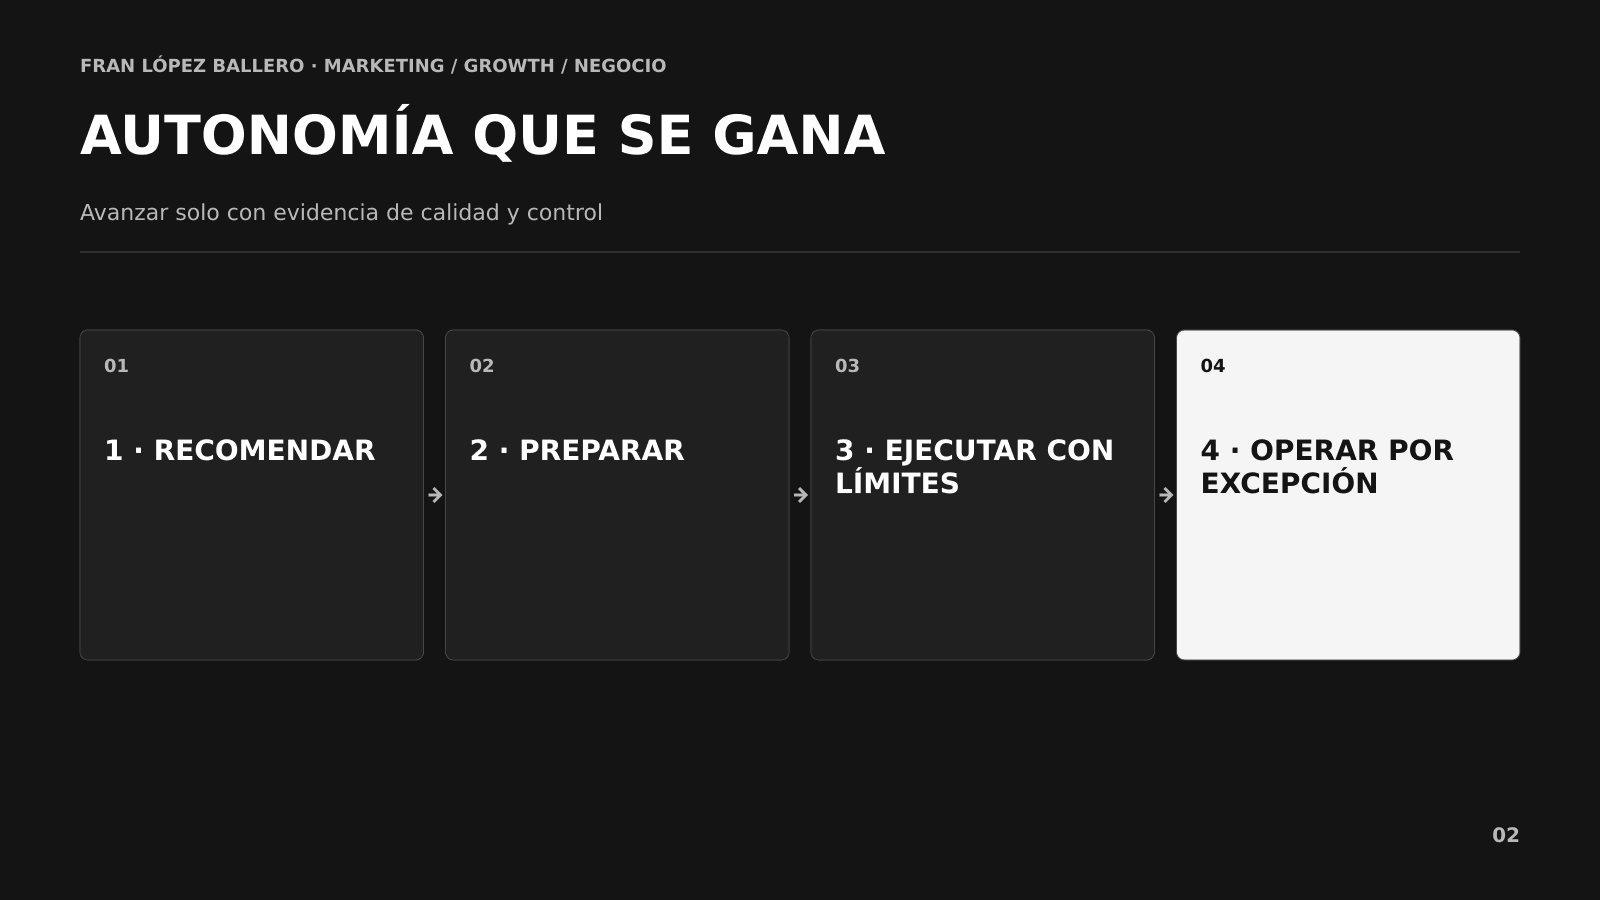
Diseñaría cuatro niveles.
1. Recomendar: analiza y propone; una persona ejecuta.
2. Preparar: crea el cambio en borrador; una persona aprueba.
3. Ejecutar con límites: actúa dentro de importe, audiencia y herramientas restringidas.
4. Operar por excepción: ejecuta de forma recurrente y escala casos anómalos.
No empezaría por el nivel cuatro. La autonomía se gana cuando existe evidencia de calidad, observabilidad y un coste de error asumible.
El nivel puede variar dentro del mismo flujo. El agente clasifica automáticamente, redacta en borrador, necesita aprobación para publicar y no puede modificar permisos.
Herramientas: conceder la capacidad mínima
Cada herramienta amplía el impacto posible. Separaría lectura y escritura, limitaría objetos y establecería importes o audiencias máximas.
Un agente que analiza campañas no necesita capacidad para cambiar presupuestos. Si más adelante la necesita, puede proponer el cambio y esperar aprobación. Los tokens, credenciales y datos deben vivir fuera del prompt y respetar permisos del usuario.
También validaría argumentos antes de ejecutar: formato, rango, destino y coherencia. El modelo propone; una capa determinista comprueba.
Memoria y contexto
La memoria no debe ser una grabación ilimitada de conversaciones. Distinguiría:
• Contexto temporal de la tarea.
• Preferencias confirmadas.
• Conocimiento recuperado de fuentes.
• Historial de acciones y resultados.
Cada categoría necesita retención, propietario y posibilidad de corrección. Guardar una suposición como verdad permanente puede degradar todas las decisiones posteriores.
Para conocimiento empresarial, utilizaría recuperación con citas y vigencia. El agente debe saber cuándo no dispone de evidencia suficiente.
Evaluar el sistema completo, no una respuesta bonita
Prepararía casos reales y mediría:
• Corrección de la decisión.
• Calidad y trazabilidad de fuentes.
• Selección de herramienta.
• Cumplimiento de límites.
• Tasa de escalado correcta.
• Errores silenciosos.
• Latencia y coste.
• Tiempo humano ahorrado.
• Resultado económico de la tarea.
Ejemplo ilustrativo sobre 200 casos:
• Métrica · Resultado
• Clasificación correcta · 92 %
• Uso correcto de herramientas · 96 %
• Salida aceptada sin cambios · 71 %
• Casos críticos escalados · 100 %
• Coste por caso · 0,42 €
El 92 % puede parecer alto y ser inaceptable si el 8 % contiene publicaciones erróneas. La evaluación debe ponderar severidad, no solo promedio.
Human in the loop con un propósito concreto
Poner una persona en cada paso elimina parte del valor y no garantiza que revise. La aprobación debe concentrarse donde cambia el perfil de riesgo:
• Uso de datos sensibles.
• Comunicación externa.
• Gasto o compromiso contractual.
• Cambios irreversibles.
• Ambigüedad alta.
• Excepción fuera de política.
La interfaz debe mostrar propuesta, evidencia, acción exacta y consecuencias. Aprobar una caja negra por fatiga es control únicamente en apariencia.
Seguridad y fallos específicos
Un agente puede recibir instrucciones maliciosas dentro de documentos, páginas o mensajes. Trataría todo contenido externo como datos, no como autoridad para cambiar sus reglas.
Controles relevantes:
• Lista cerrada de herramientas.
• Permisos mínimos y por tarea.
• Aislamiento de datos.
• Validación de entradas y salidas.
• Presupuesto de pasos, tiempo y coste.
• Idempotencia y prevención de duplicados.
• Logs y capacidad de detener.
• Pruebas adversariales.
También diseñaría para fallos normales: API caída, respuesta incompleta, dato obsoleto o herramienta que devuelve éxito sin aplicar el cambio.
Unit Economics de un agente
El business case no puede limitarse al coste del modelo. Incluiría integración, revisión humana, mantenimiento, evaluación, errores y oportunidad.
Valor neto = tiempo ahorrado + mejora de resultado − coste tecnológico − supervisión − coste esperado de error
Un agente que ahorra cinco minutos en una tarea poco frecuente quizá no merece operación. Uno que reduce errores en miles de activos puede crear valor aunque necesite revisión.
Mediría coste por tarea completada correctamente, no por llamada. Si requiere tres reintentos y una corrección humana, ese es el coste real.
Hoja de ruta para implantar agentes
1. Seleccionar una tarea repetible y medible.
2. Dibujar proceso actual, excepciones y coste.
3. Definir límites y resultado correcto.
4. Construir una línea base sin agente.
5. Empezar en modo recomendación.
6. Crear un set de evaluación con casos difíciles.
7. Añadir herramientas una a una.
8. Introducir aprobaciones por riesgo.
9. Medir calidad, economía y adopción.
10. Ampliar autonomía solo con evidencia.
Errores frecuentes
• Automatizar un proceso que todavía no se entiende.
• Dar acceso amplio para «facilitar» el piloto.
• Evaluar con demos elegidas.
• Confundir tono fluido con corrección.
• Guardar memoria sin gobernanza.
• No diseñar abstención ni escalado.
• Medir tokens y olvidar coste humano.
• Añadir varios agentes cuando un workflow basta.
• Publicar o gastar sin control proporcional.
Preguntas frecuentes
¿Un agente necesita autonomía completa?
No. Muchos casos valiosos recomiendan o preparan borradores. La autonomía es un parámetro de diseño, no una definición de éxito.
¿Agente y RAG son lo mismo?
No. RAG aporta conocimiento recuperado. Un agente puede usar RAG como herramienta y además decidir pasos o ejecutar acciones.
¿Cuándo escalar a producción?
Cuando existe evaluación representativa, controles de permisos, observabilidad, propietario operativo y economía mejor que la alternativa.
Conclusión: automatizar ejecución sin abdicar criterio
Los agentes reducirán fricción táctica, pero harán más importante el diseño de decisiones. Definir qué puede hacer el sistema, con qué evidencia y bajo qué límites será parte del trabajo de Marketing.
El objetivo no es construir una organización sin personas. Es reservar el juicio humano para ambigüedad, contexto y responsabilidad, mientras la máquina asume tareas repetibles con trazabilidad. La autonomía útil no se declara en una demo; se gana con evaluación, control y resultados.