Causalidad frente a atribución: holdouts, geotests y lift


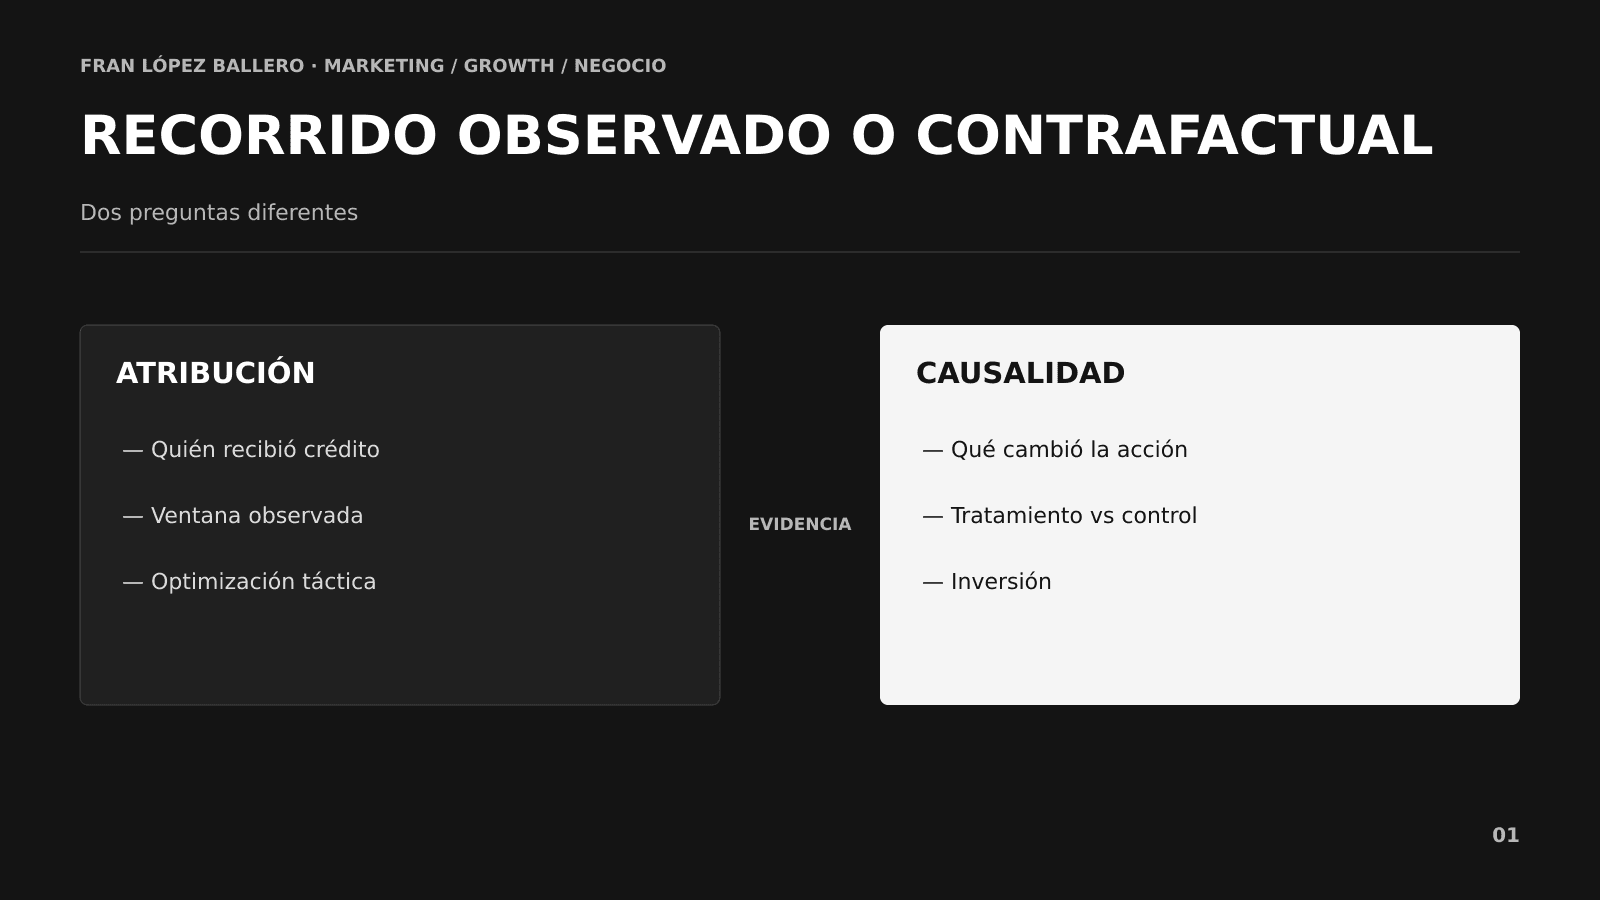
La atribución explica cómo una conversión se relaciona con contactos observados; la causalidad intenta saber si cambiar una acción produjo un resultado distinto. Holdouts, geoexperimentos y estudios de lift construyen contrafactuales para estimar ese efecto.
No existe un método perfecto para todas las decisiones. La calidad depende de la unidad de asignación, potencia, contaminación, supuestos y estabilidad del entorno. El objetivo no es obtener un único número «causal», sino construir la evidencia suficiente para una decisión económica concreta.
La pregunta debe formularse antes del diseño: si aumentamos, reducimos o retiramos esta inversión, ¿qué resultado cambiará y en qué población?
Por qué la atribución no demuestra causalidad
Los usuarios expuestos a una campaña no son necesariamente comparables con los no expuestos. El algoritmo busca personas con mayor intención; las búsquedas de marca aparecen cerca de la compra; el CRM contacta a clientes conocidos.
Una atribución puede asignar crédito correctamente según su regla y sobreestimar el efecto causal. Cambiar de último clic a un modelo algorítmico distribuye crédito de otro modo, pero no crea por sí solo un contrafactual.
La causalidad pregunta qué habría ocurrido sin intervención. Como no observamos los dos estados en la misma unidad, necesitamos diseño.
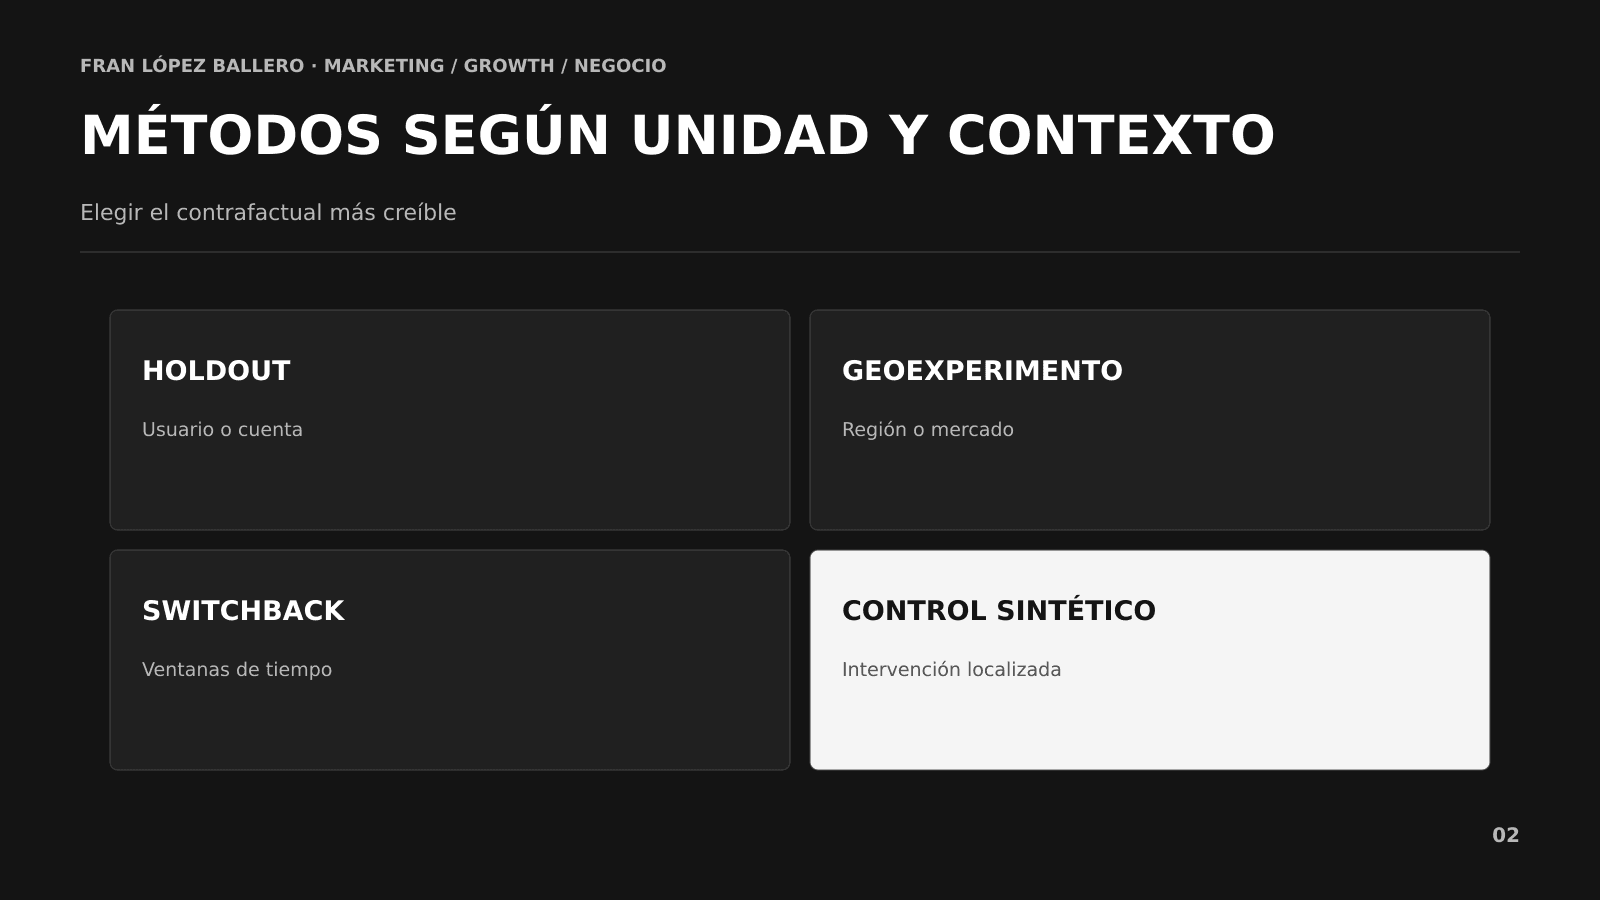
Elegir la unidad experimental
Usuario o cuenta
Adecuado cuando podemos identificar y asignar de forma estable. Útil en CRM, producto y algunas plataformas. Riesgo: exposición cruzada entre dispositivos o miembros de una cuenta.
Región
Útil para medios agregados, offline o efectos de marca. Necesita suficiente número de geografías, tendencias comparables y poca contaminación.
Tienda o unidad
Valioso en redes físicas. Debe considerar capacidad, stock y diferencias locales.
Tiempo
Los switchback tests alternan tratamiento por ventanas. Sirven cuando la intervención afecta al sistema completo y el efecto se disipa rápido. Son sensibles a estacionalidad y carryover.
La unidad de análisis debe respetar la de asignación. Tratar miles de usuarios dentro de cuatro regiones como observaciones independientes exagera la potencia.
Holdouts aleatorizados
Asignan una parte elegible a control y otra a tratamiento. La aleatorización equilibra, en expectativa, factores observados y no observados.
Antes de lanzar definiría:
• Hipótesis y métrica primaria.
• Población elegible.
• Ratio tratamiento/control.
• Efecto mínimo detectable.
• Duración y estacionalidad.
• Exposición real.
• Guardrails.
• Regla de análisis.
Comprobaría equilibrio inicial, sample ratio mismatch y pérdida de tracking. El análisis por intención de tratar conserva la asignación original; analizar solo expuestos puede reintroducir sesgo.
Geoexperimentos
Comparan regiones tratadas con un contrafactual construido a partir de regiones control. Pueden utilizar emparejamiento, diferencias en diferencias, control sintético u otros modelos.
La selección se apoya en tendencias históricas, tamaño, mix y estabilidad. El tratamiento debe crear una diferencia suficiente de inversión sin provocar daño desproporcionado.
Registraría promociones, distribución, aperturas, stock, clima relevante y actividad comercial. Una campaña nacional paralela puede contaminar el contraste.
El resultado debe probarse con especificaciones alternativas y periodos placebo. Si el efecto solo aparece con una selección muy concreta, la conclusión es frágil.
Diferencias en diferencias
Compara el cambio antes-después del tratamiento con el cambio de un control. Su supuesto clave es que, sin intervención, ambos habrían seguido tendencias paralelas.
No basta con que los niveles sean parecidos. Examinaría tendencias previas y posibles shocks diferenciales. El método puede ser potente y también producir una historia convincente cuando el supuesto no se sostiene.
Control sintético
Construye una combinación ponderada de unidades no tratadas que reproduce el comportamiento previo de la unidad tratada. Es útil con pocas unidades grandes y una intervención claramente localizada.
La credibilidad depende del ajuste pretratamiento, de que no haya spillovers y de disponer de donantes comparables. Placebos en otras unidades ayudan a contextualizar el tamaño del efecto.
Potencia, MDE e incertidumbre
El efecto mínimo detectable o MDE es el cambio más pequeño que el diseño tiene una probabilidad razonable de detectar. No debe elegirse solo por conveniencia estadística; debe ser económicamente relevante.
Un test con poca potencia puede no encontrar significación aunque el efecto sea valioso. Un test enorme puede detectar una diferencia minúscula sin impacto económico.
Comunicaría estimación e intervalo:
El efecto estimado es +4 %, con un rango compatible entre −1 % y +9 %.
La decisión depende de reversibilidad y coste de error. No convertiría «no significativo» en «cero» ni un p-valor bajo en certeza de negocio.
Del efecto al margen incremental
Ejemplo ilustrativo:
• Inversión: 100.000 euros.
• Ventas atribuidas: 5.000.
• Ventas incrementales estimadas: 800.
• Margen por venta: 90 euros.
El CPA atribuido es 20 euros. El CAC incremental es 125. El margen incremental total es 72.000 euros: inferior a la inversión.
La campaña puede mostrar ROAS positivo con ingresos brutos y destruir contribución. Por eso el análisis causal debe terminar en margen, payback y escenario de escala.
Una jerarquía práctica de evidencia
No siempre podemos aleatorizar. Utilizaría la evidencia más fuerte viable:
1. Experimento aleatorizado bien ejecutado.
2. Geo o switchback con contrafactual defendible.
3. Diseño cuasiexperimental con supuestos comprobables.
4. Modelo observacional y triangulación.
5. Atribución descriptiva.
6. Opinión informada.
La jerarquía no convierte niveles inferiores en inútiles. Obliga a ajustar confianza y tamaño de la decisión.
Triangulación
Combinaría experimentos, MMM, atribución y conocimiento operativo.
Si el holdout muestra poco lift, el MMM atribuye gran contribución y la búsqueda de marca crece, quizá exista un efecto retardado o una mala ventana. Si todos apuntan en la misma dirección, aumenta confianza. Si divergen, aparece una agenda de aprendizaje.
La evidencia no se suma como votos. Cada método tiene sesgos distintos; el objetivo es comprobar si una explicación sobrevive a varios ángulos.
Errores frecuentes
• Diseñar el análisis después de ver el dato.
• Tratar exposición y asignación como equivalentes.
• Ignorar interferencia entre unidades.
• Utilizar usuarios como muestras independientes en un geo test.
• No comprobar tendencias paralelas.
• Detener por significación temprana.
• Confundir ausencia de evidencia con ausencia de efecto.
• Comunicar lift sin economía.
• Extrapolar a presiones no probadas.
Preguntas frecuentes
¿Qué método es mejor?
El que construye el contrafactual más creíble para la decisión, dentro de las restricciones de negocio y ética. La aleatorización suele ser preferible, pero no siempre es viable.
¿Cuánto debe durar un test?
Lo suficiente para alcanzar potencia, cubrir ciclos relevantes y capturar retardos, sin incluir cambios estructurales innecesarios. Se decide antes con volumen y MDE.
¿Puedo usar resultados de una plataforma?
Sí, si comprende población, asignación, exposición, ventana y método. Deben conectarse con datos de negocio y, cuando sea posible, replicarse.
Conclusión: la causalidad es una disciplina de decisión
Medir causalidad no consiste en buscar una etiqueta estadística que cierre la discusión. Consiste en diseñar un contraste, hacer visibles sus supuestos y traducir el efecto a valor económico.
La atribución mantiene velocidad operativa. Los experimentos y cuasiexperimentos aportan un contrafactual para decisiones de inversión. Utilizados juntos, permiten dejar de preguntar quién se lleva el crédito y empezar a preguntar qué acción creó realmente valor.